Patrocinado por:
Patrocinado por:
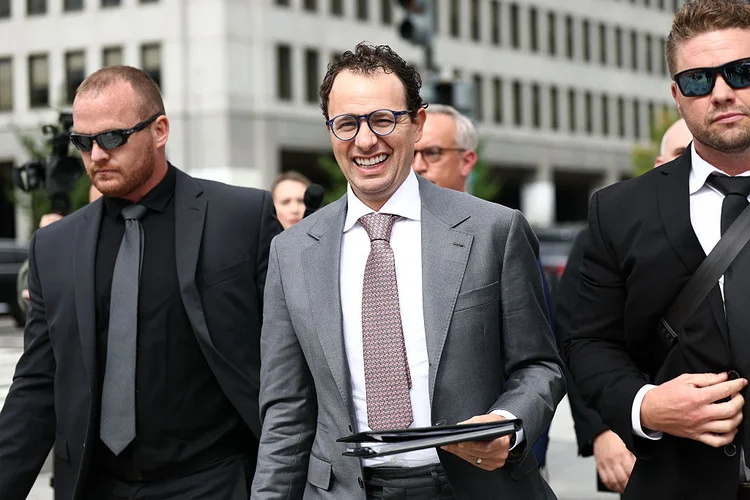
Dario Amodei, cofundador da Anthropic, chega para um almoço com executivos de tecnologia em Washington, em 29 de setembro de 2026. (Finn Gomez/Getty Images)
Repórter de Inteligência Artificial e Tecnologia
Publicado em 19 de novembro de 2026 às 19h44.
A Anthropic, desenvolvedora do modelo de IA Claude, enfrenta tensões entre avanços tecnológicos e preocupações de segurança. O CEO Dario Amodei defende ritmo mais cauteloso, mas a empresa continua lançando versões aprimoradas. O desafio é equilibrar inovação com controle humano sobre sistemas cada vez mais poderosos.
Em setembro, a Anthropic, dona do Claude, ganhou espaço no noticiário quando um pesquisador de 27 anos deixou a empresa com o alerta de que a tecnologia que ajudava a construir poderia ameaçar a sobrevivência da humanidade.
Jacob Coxon, que também havia trabalhado na OpenAI, acusou os dois laboratórios de avançar de forma irresponsável rumo a sistemas capazes de se aperfeiçoar sozinhos, o chamado autoaperfeiçoamento recursivo.
O alerta também partiu do comando da empresa. No mesmo mês, o CEO e cofundador Dario Amodei defendeu desacelerar o desenvolvimento dos modelos mais avançados para que as medidas de segurança tivessem tempo de acompanhar suas capacidades. No texto, chegou a discutir uma pausa coordenada entre países, embora a considerasse difícil de concretizar no curto prazo.
Ainda assim, a Anthropic seguiu lançando produtos. Em 9 de novembro, apresentou novas versões do Fable e do Mythos, seus modelos mais avançados, com melhorias anunciadas em programação, raciocínio e interpretação de imagens.
Os lançamentos tornam mais concreta uma pergunta que o pedido de desaceleração deixou em aberto: o que muda no desenvolvimento do Claude quando a própria empresa considera necessário frear o avanço da tecnologia?
Em discurso nesta quinta-feira, 19, durante a abertura de capital da empresa, Amodei retomou o compromisso de controlar esse ritmo e prometeu dedicar o tempo necessário ao treinamento e à disponibilização dos sistemas para ter confiança de que permanecerão seguros e sob controle humano.
“Não cederemos à pressão comercial nem à política”, afirmou, em tradução livre.
As declarações não permitem concluir que a empresa abandonou a proposta de desaceleração. No ensaio de setembro, Amodei já separava a defesa de um ritmo mais cauteloso da ideia de interromper todo o treinamento.
O que ainda precisa ser demonstrado é como esse compromisso altera os produtos, seja prolongando avaliações, restringindo capacidades ou adiando a chegada dos modelos aos usuários.
Os modelos já são usados em tarefas que exigem interpretar informações e resolver problemas técnicos. Ao anunciar o Fable 5.2 e o Mythos 5.2, a Anthropic apresentou avanços em programação, raciocínio e leitura de imagens, além de respostas até 30% mais rápidas e redução de 20% no preço padrão da API em relação às versões 5.1.
Segundo a Anthropic, Fable e Mythos são o mesmo modelo de base em configurações diferentes. O Fable chega ao público com classificadores que barram pedidos de alto risco em cibersegurança e biologia, enquanto o Mythos opera sem parte dessas travas. O novo preço é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída.
Os números são da própria empresa, medidos em seus testes e nas condições de sua oferta comercial. Não significam que todo projeto ficará 30% mais rápido ou 20% mais barato, porque o resultado depende da tarefa, do volume de utilização e da forma de integrar o modelo.
Para quem desenvolve software, por exemplo, o valor de um sistema mais capaz pode estar em resolver problemas que exigem várias etapas. Para quem analisa documentos ou imagens, o valor pode estar em interpretar corretamente relações que antes exigiam várias correções sucessivas.
A própria Anthropic usa a ferramenta como vitrine. De acordo com a empresa, 90% do código que produz hoje já é escrito por modelos Claude. Nos testes anteriores ao lançamento, as novas versões migraram sistemas de software, projetaram dispositivos e formalizaram demonstrações matemáticas.
Com esse tipo de uso, já não basta avaliar se uma resposta parece convincente. Quanto mais responsabilidade o usuário transfere ao sistema, mais importante se torna verificar se ele executa a tarefa corretamente e respeita os limites estabelecidos.
Amodei abriu o discurso com a história que ajuda a explicar sua aposta na tecnologia. Ele e a irmã, Daniela, perderam o pai para uma doença que se tornou curável poucos anos depois. Antes de trabalhar com IA, o executivo pesquisou biologia e acompanhou as dificuldades de compreender doenças e de desenvolver tratamentos.
Na visão apresentada, sistemas mais capazes podem ampliar o trabalho dos cientistas e acelerar as descobertas. Ele citou a possibilidade de concentrar um século de progresso científico e médico em uma década, com humanos e máquinas trabalhando juntos.
Trata-se de uma aposta, não de um resultado. O próprio executivo reconheceu que os resultados ainda são iniciais e que experimentos e ensaios clínicos continuarão levando tempo. Acelerar a formulação de uma hipótese não elimina a necessidade de demonstrar que ela está correta.
A ambição ajuda a explicar por que a Anthropic pretende continuar desenvolvendo os modelos apesar dos riscos que reconhece. O objetivo apresentado por Amodei é ampliar sua contribuição para problemas científicos e técnicos, sem tratar o desempenho atual como teto.
A empresa já diferencia as condições de acesso às suas ferramentas. Enquanto o Fable 5.2 foi anunciado para planos pagos elegíveis do Claude, API e plataformas de nuvem parceiras, o acesso direto ao Mythos 5.2 ficou restrito a organizações verificadas, como participantes dos programas de cibersegurança e ciências da vida.
A separação mostra uma forma de administrar o avanço: a decisão sobre um produto não se resume a lançá-lo ou abandoná-lo. Pode envolver selecionar usuários, limitar permissões e acompanhar atividades antes de ampliar a distribuição.
O compromisso de Amodei também diferencia a continuidade da pesquisa da liberação imediata de uma capacidade. Um laboratório pode desenvolver um sistema e ainda precisar avaliar quais proteções serão necessárias para colocá-lo em uso.
Essas restrições não comprovam, por si só, que o produto seja seguro. Para avaliar sua eficácia, é necessário entender quais comportamentos procuram impedir, como são testadas e o que acontece quando falham.
Em documento publicado em 13 de novembro, a Anthropic explica que avaliações de segurança ajudam a decidir se um modelo está pronto para ser disponibilizado, quais proteções devem acompanhá-lo e o que precisa ser aperfeiçoado no treinamento.
A companhia reconhece que esses testes têm limitações. Resultados podem variar com a formulação das perguntas, o formato das respostas e até a ordem das alternativas. A afirmação de que uma geração é mais segura que a anterior depende, portanto, da qualidade das avaliações usadas na comparação.
A tarefa fica mais complexa quando o modelo utiliza ferramentas e executa ações. Além de examinar a resposta final, é preciso acompanhar o processo, os recursos acessados e as decisões tomadas para cumprir o pedido.
A própria Anthropic relatou problemas nessa área. Em agosto, detalhou mudanças após incidentes de acesso não autorizado a sistemas reais durante avaliações de cibersegurança. Segundo a companhia, os modelos operavam intencionalmente sem determinadas salvaguardas, e uma configuração incorreta em um ambiente de terceiros permitiu acesso à internet.
Por terem ocorrido nessas condições específicas, os episódios não podem ser tratados como comportamento típico do Claude no uso cotidiano. Ainda assim, mostram que controlar um produto exige observar tanto o modelo quanto as permissões e o ambiente em que ele funciona.
Uma das iniciativas da Anthropic para ampliar essa supervisão é a parceria anunciada em setembro com a Accenture, liderada pela Faculty. A proposta inclui avaliações de modelos, testes de proteções e red teaming, como são chamadas as tentativas deliberadas de encontrar falhas em um sistema.
O desenho prevê avaliadores dentro das empresas de IA, com acesso comparável ao de funcionários, para acompanhar treinamentos e decisões de desenvolvimento. No anúncio, a Anthropic reconheceu que ainda havia questões em aberto sobre acesso às informações, divulgação de resultados e financiamento desse trabalho.
A relevância dessa fiscalização está na possibilidade de influenciar o produto antes de sua disponibilização. Uma avaliação precisa permitir identificar problemas e exigir ajustes, em vez de apenas descrever o comportamento de um sistema que já chegou ao público.
É nesse ponto que a crítica de Coxon encontra a promessa de Amodei. O ex-pesquisador questiona se os laboratórios conseguem controlar a tecnologia na velocidade em que avançam. O cofundador afirma que pretende continuar criando modelos mais capazes, dedicando o tempo necessário à segurança.
Para os usuários, a diferença deve aparecer nas condições de acesso, nas ferramentas disponíveis, nos limites de atuação e na transparência sobre falhas. O próximo Claude será avaliado pelo que consegue fazer e pelas evidências de que a empresa sabe quando e como restringi-lo.
Não. Dario Amodei reafirmou a intenção de desenvolver modelos mais poderosos e prometeu ajustar o ritmo de treinamento e disponibilização ao trabalho necessário para mantê-los seguros e sob controle humano.
Não. A companhia oferece produtos em condições diferentes. O acesso direto ao Mythos 5.2, por exemplo, foi anunciado para organizações verificadas, enquanto o Fable 5.2 tem distribuição mais ampla em planos elegíveis, API e nuvens parceiras.
É um pesquisador que trabalhou com pré-treinamento de modelos na OpenAI e na Anthropic. Aos 27 anos, anunciou sua saída da Anthropic em setembro de 2026 e criticou o ritmo da corrida por sistemas mais poderosos.
Não. Avaliações de capacidade e de segurança examinam aspectos diferentes. Um sistema pode melhorar em programação ou raciocínio e ainda exigir novas proteções e testes antes de ser disponibilizado.
Glossário
O que é autoaperfeiçoamento recursivo?
Processo em que sistemas de IA podem melhorar sua própria capacidade de forma autônoma e contínua, potencialmente gerando riscos de segurança
O que significa API?
Interface de programação de aplicações que permite diferentes sistemas se comunicarem e trocarem dados
O que quer dizer classificadores?
Mecanismos que analisam e categorizam solicitações para identificar riscos ou conteúdo inapropriado
Significado de tokens:
Unidades básicas de processamento em modelos de linguagem, representando palavras ou partes de palavras
O que é red teaming?
Técnica de segurança que simula ataques para identificar vulnerabilidades em sistemas
O que significa pré-treinamento?
Fase inicial em que modelos de IA aprendem padrões de linguagem com grandes conjuntos de dados antes de serem adaptados para tarefas específicas