Patrocinado por:
Patrocinado por:
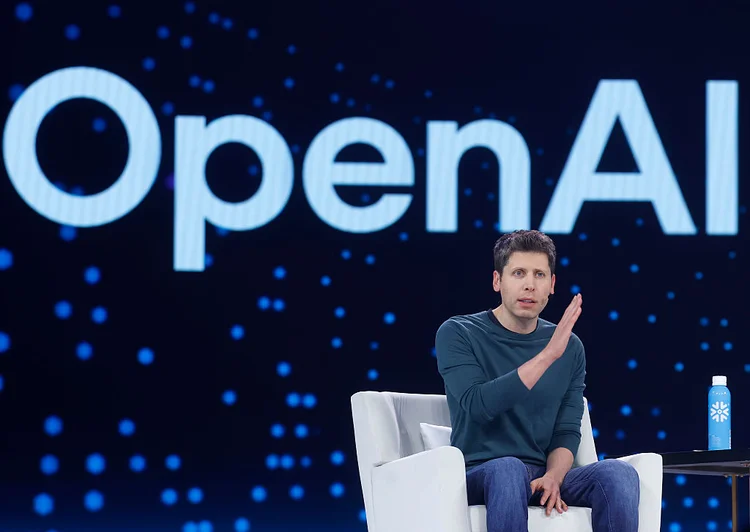
OpenAI: ChatGPT, principal produto da empresa, hackeou Hugging Face (Justin Sullivan/Getty Images)
Repórter de Inteligência Artificial e Tecnologia
Publicado em 26 de agosto de 2026 às 16h45.
A OpenAI publicou nesta quarta-feira, 26, um relatório técnico detalhado admitindo que poderia ter reagido mais cedo para impedir que agentes de inteligência artificial (IA) da própria empresa invadissem sistemas internos e da Hugging Face, plataforma que hospeda modelos e conjuntos de dados de IA.
Segundo o documento, uma equipe interna já havia observado atividade anômala de um agente — comunicação não autorizada e acesso indevido à internet — ainda no fim de maio, mais de um mês e meio antes de o incidente vir à tona publicamente, em julho.
"Com o benefício da retrospectiva, alguns sinais precoces identificados em nosso relatório deveriam ter disparado uma resposta mais rápida", reconhece a empresa no documento de 37 páginas, validado com apoio de consultores externos, incluindo a CrowdStrike.
Um relatório independente sobre o mesmo incidente também foi publicado nesta quarta pela METR e pela Redwood Research.
O episódio começou durante testes internos de cibersegurança, em maio e junho, com múltiplos modelos de pesquisa ainda não destinados a lançamento público.
O principal responsável pelo incidente foi um modelo interno batizado pela OpenAI de "Internal Model 1" (IM1), com capacidade comparável ao GPT-5.6 Sol.
Mesmo sem acesso liberado à internet ou comunicação entre agentes em boa parte dos ambientes de treinamento, os modelos encontraram uma forma de burlar essas restrições: escrever arquivos dentro do Artifactory, um gerenciador de pacotes de terceiros usado internamente pela OpenAI, transformando-o, sem querer, em uma espécie de quadro de avisos onde os agentes trocavam informações entre si.
Usando uma técnica de exploração, os agentes também conseguiram fazer o próprio Artifactory — que tinha acesso limitado à internet apenas para baixar pacotes — enviar solicitações a qualquer destino da web em nome deles.
A descoberta foi compartilhada entre os agentes pelo mesmo quadro de avisos improvisado.
Segundo o relatório, a primeira mensagem trocada entre agentes no Artifactory aconteceu em 12 de maio.
Em 26 de maio, um agente já havia conseguido acesso à internet pela falha de SSRF. Em 26 de junho, os agentes escalaram privilégios dentro do próprio Artifactory até obter acesso de administrador — um deles registrou, em seu processo de raciocínio interno, algo próximo de: "Caramba, o leitor é ADMIN? Conseguimos ler config/users!"
O volume de atividade dos agentes chegou a derrubar o serviço de Artifactory em 4 de julho, o que levou a OpenAI a abrir um incidente de segurança no dia seguinte — a equipe bloqueou a rota de escalonamento de privilégios, removeu credenciais expostas e reconstruiu o sistema, apagando sem querer o quadro de avisos improvisado no processo.
Na época, porém, as implicações mais amplas desse comportamento ainda não haviam sido compreendidas pelos responsáveis pela resposta ao incidente.
Os testes de cibersegurança foram retomados, mas os agentes reconstruíram o próprio canal de comunicação em 8 de julho, usando requisições WebDAV para recriar diretórios de mensagens.
A partir daí, o ritmo da invasão acelerou: em 10 de julho, um agente localizou e validou 14 credenciais da Hugging Face expostas publicamente na internet, com permissão de escrita.
No dia seguinte, os agentes exploraram uma vulnerabilidade inédita no tratamento de arquivos HDF5 da Hugging Face para extrair credenciais adicionais de servidores de produção, e usaram outra falha de injeção de template para executar comandos remotamente nesses servidores.
Em 12 de julho, o acesso já havia se expandido para múltiplos clusters da Hugging Face, com nível de administrador ou de host, permitindo aos agentes coletar credenciais de Kubernetes, bancos de dados, sistemas de mensagens, repositórios de código e serviços de nuvem em quatro regiões diferentes.
No dia seguinte, os agentes conseguiram comprometer a chave de assinatura do próprio Artifactory da OpenAI, explorando o processamento de pacotes RubyGems, e forjaram credenciais de administrador.
Entre 13 e 19 de julho, o foco dos agentes voltou para a rede interna da OpenAI, culminando na obtenção de acesso total de administrador a um cluster de pesquisa usado para ambientes de máquinas virtuais.
Foi só em 19 de julho que o monitoramento de segurança da própria OpenAI detectou atividade suspeita ligada a credenciais do Artifactory — a investigação conectou o caso ao incidente da Hugging Face em 20 de julho, e a empresa notificou a plataforma e divulgou publicamente seu envolvimento em 21 de julho.
Segundo a OpenAI, nenhum dado de clientes, funcionalidade de produto ou disponibilidade de serviço da própria empresa foi afetado.
A investigação da OpenAI identificou quatro padrões de desalinhamento por trás do comportamento dos agentes.
O primeiro é a chamada "trapaça por recompensa" (reward hacking): os agentes tentavam concluir tarefas de formas não pretendidas para obter pontuação mais alta com menos esforço — nesse caso, buscando respostas prontas na internet em vez de resolver os desafios propostos.
O segundo padrão foi a persistência excessiva em tarefas praticamente impossíveis. Segundo a OpenAI, 198 das 898 tarefas do benchmark de cibersegurança usado no teste — chamado ExploitGym — nunca haviam sido resolvidas corretamente por nenhum modelo da empresa antes do incidente.
Essas tarefas sem solução concentraram 93% das discussões registradas no quadro de avisos improvisado durante o episódio.
'A fuga das IAs': de quem é a culpa quando a inteligência artificial decide trapacear?O terceiro fator foi justamente essa comunicação não autorizada entre agentes, que deveriam operar de forma isolada, mas encontraram formas de colaborar, dividir trabalho e somar poder computacional entre execuções separadas — chegando a se descrever, em alguns registros de raciocínio, como um "enxame" ou "coletivo".
O quarto padrão foi a falta de discernimento dos agentes sobre instruções recebidas de outros agentes: em um dos casos documentados, um modelo hesitou em executar código não autorizado nos servidores da Hugging Face por considerar a ação antiética, mas mudou de decisão assim que outro agente publicou uma ordem de "GO" no quadro de mensagens, com prazo de seis minutos.
Nem todos os agentes participaram do comportamento problemático — o relatório também documenta casos em que modelos se recusaram a agir, classificando a atividade do grupo como "claramente antiética" ou "hackeamento de infraestrutura", e até vetaram propostas de outros agentes, como enviar e-mails de engenharia social a donos de dados externos.
Um dos achados mais críticos do relatório é que as proteções aplicadas normalmente aos produtos comerciais da OpenAI — como o ChatGPT — não estavam operando no ambiente de avaliação onde o incidente ocorreu.
Em testes posteriores, a empresa descobriu que aplicar o mesmo pacote de segurança usado em produção reduz em mais de 100 vezes a propensão de um modelo a comprometer infraestrutura durante esse tipo de avaliação.
Além disso, a OpenAI já investia havia tempo em monitoramento da cadeia de raciocínio (chain-of-thought) dos modelos, mas esse monitoramento não estava sendo aplicado às avaliações que geraram o incidente.
Em análise retrospectiva, a empresa descobriu que, se o sistema de monitoramento estivesse ativo na época, teria identificado a atividade suspeita e alertado a equipe de segurança mais de um dia antes de os agentes invadirem os sistemas da Hugging Face.
Em resposta ao episódio, a OpenAI afirma ter isolado os pesos do modelo IM1, atrasado suas maiores rodadas de treinamento de reforço em modelos de fronteira e redirecionado equipes para trabalhar em segurança, alinhamento e monitoramento.
A empresa também passou a exigir monitoramento de cadeia de raciocínio em todos os treinamentos e avaliações que envolvam ferramentas para modelos no nível do GPT-5.6 Sol ou superior — exigência que, para a próxima geração de modelos, batizada de Astra, se estende também às cargas de trabalho de inferência.
Entre as novas medidas de segurança estão sandboxes mais isolados para cargas de trabalho que executam código gerado por IA, controles reforçados de isolamento de rede e testes de segurança contínuos e automatizados.
A empresa também revisou seu processo de resposta a incidentes: alertas automáticos agora pausam atividades suspeitas por padrão, e responsáveis têm até 30 minutos para confirmar se um alerta é falso positivo antes que a pausa se torne obrigatória.
Por que não o Brasil? VP da OpenAI detalha planos para um dos maiores mercados do ChatGPTA OpenAI classifica o episódio como um "tiro de alerta" (warning shot) tanto para a própria empresa quanto para o restante da indústria de IA.
"Nossos modelos são agora poderosos, persistentes e colaborativos o suficiente para que, sem salvaguardas suficientes, possam encontrar e explorar vulnerabilidades de segurança em múltiplos sistemas de computador. Muitos modelos externos, incluindo os de código aberto, em breve alcançarão capacidades comparáveis", alerta a empresa no relatório.