Patrocinado por:
Patrocinado por:
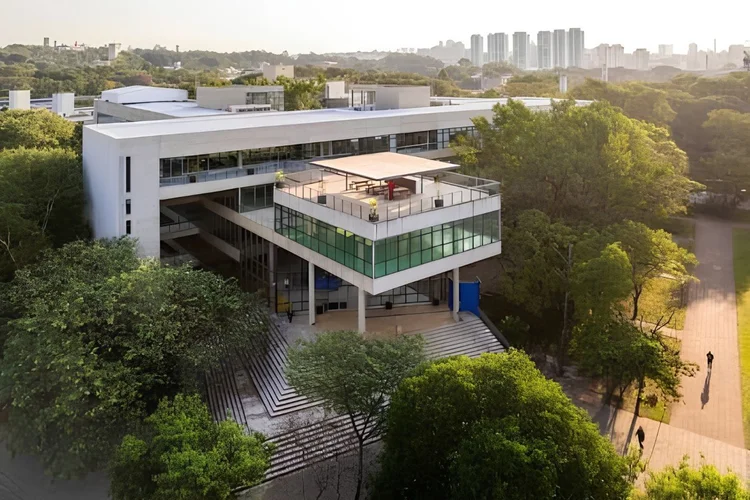
Centro de Inteligência Artificial da USP (C4AI), responsável por integrar línguas indígenas ao modelo LatAm GPT. (USP/Divulgação)
Editor de Inteligência Artificial e Tecnologia
Publicado em 19 de agosto de 2026 às 11h16.
O Centro de Inteligência Artificial da USP (C4AI) participará da segunda versão do LatAm GPT, o modelo de linguagem aberto construído por e para a América Latina. E a contribuição brasileira será das mais simbólicas: línguas indígenas.
O anúncio foi feito por Fabio Cozman, diretor do centro, durante o Super Bots Experience 2026, na terça-feira, 18. Uma língua já está confirmada no projeto, o quéchua, falado por povos originários dos Andes, em países como Peru e Chile. Pelo lado brasileiro, a decisão está entre duas opções:
Lançado em 10 de fevereiro em Santiago, com a presença do presidente chileno Gabriel Boric, o LatAm GPT é o primeiro grande modelo de linguagem aberto criado com dados, idiomas e contextos da região. É coordenado pelo CENIA, o Centro Nacional de Inteligência Artificial do Chile, e reúne mais de 100 profissionais e 60 instituições acadêmicas de 15 países, entre eles Brasil, México, Colômbia, Argentina, Uruguai, Peru e Equador.
O modelo tem 70 bilhões de parâmetros e foi construído sobre a arquitetura Llama 3.1, o modelo aberto da Meta, refinada com mais de 300 bilhões de tokens de texto obtidos com licenças explícitas. Roda hoje na nuvem da Amazon Web Services. O C4AI da USP entrou fornecendo dados e validando o resultado.
A lógica do projeto é reduzir a dependência de modelos treinados majoritariamente em inglês e com referências culturais do Norte Global, que erram nuances, gírias, sotaques e contextos históricos latino-americanos. Para Cozman, considerando cultura e contexto regional, o modelo construído com o CENIA é o mais avançado disponível hoje.
A inclusão não é gesto apenas simbólico. Línguas com poucos falantes e pouco material digitalizado tendem a desaparecer da internet e, por consequência, dos sistemas de IA treinados nela. Sem presença nos modelos, ficam de fora de tradutores, assistentes, ferramentas educacionais e de qualquer serviço público que venha a ser mediado por inteligência artificial.
O primeiro esforço nessa frente foi um tradutor para o rapanui, da Ilha de Páscoa, e há trabalho em andamento com o bribri, na Costa Rica.M
Mas há uma camada de ironia produtiva no arranjo. O modelo latino-americano é construído sobre uma base americana e roda em nuvem americana. A soberania, aqui, não está no código-fonte, e sim no que se coloca dentro dele: dados, contexto e, agora, as línguas que o Vale do Silício nunca teria motivo comercial para aprender.